17 Psicoacústica: cómo oímos de verdad (y por qué importa)
17.1 La idea, en una frase
Durante todo lo anterior hemos tratado el sonido como una magnitud física que se puede capturar, graficar y medir: presiones, espectros, tiempos de decaimiento. Pero hay un eslabón final que ningún micrófono atraviesa. Entre la onda que llega al tímpano y la experiencia de oír media un órgano que no registra la realidad, sino que la construye. El oído —y sobre todo el cerebro detrás de él— no es un instrumento de medida: es un intérprete que decidió, a lo largo de millones de años, que sobrevivir importaba más que ser fiel. Descartar información, adivinar, dar prioridad a lo urgente sobre lo exacto: eso que en un micrófono serían defectos imperdonables, en la audición son precisamente las virtudes que nos permiten entender una voz en medio del ruido.
De ahí una consecuencia que desconcierta a todo ingeniero primerizo: el sonido “correcto” no existe fuera del que lo escucha. Un sistema que mide perfecto puede sonar mal, y uno con defectos evidentes “en el papel” puede sonar excelente, porque la vara con la que se juzga no está en el analizador, sino en la cabeza del oyente. Diseñar sonido sin conocer al oyente es como pulir una imagen para un ojo que no sabemos cómo ve. La psicoacústica es el mapa de ese ojo: el estudio de cómo la percepción se aparta —de forma sistemática y, felizmente, predecible— de la física.
Y esas desviaciones no son caprichosas ni infinitas. Buena parte de la práctica se apoya sobre un puñado de reglas robustas, medidas mil veces, que describen cómo el cerebro comprime, ordena y localiza lo que le llega. Cuatro fenómenos, en particular, gobiernan casi todo el diseño práctico:
- Precedencia (efecto Haas): localizamos el sonido según la primera onda que llega, aunque las reflexiones posteriores sean más fuertes.
- Enmascaramiento: un sonido fuerte oculta a otro más débil cercano en frecuencia o en tiempo — la base de los códecs MP3/AAC.
- Sonoridad: el mismo nivel en dB no suena igual de fuerte a todas las frecuencias; las frecuencias bajas y las frecuencias altas necesitan más nivel para igualar a los medios.
- Localización: situamos las fuentes usando las diferencias de tiempo y nivel entre los dos oídos.
Idea claveIdea clave
La primera onda manda. Por eso, en una sala reverberante, sigues sabiendo de dónde viene la voz aunque haya reflexiones por todas partes — y por eso un simple retardo mal puesto puede “mover” una fuente o convertirse en eco.
Vívelo con el efecto Haas. Dos altavoces con la misma señal; el derecho llega con retardo. Con auriculares, sube el retardo desde 0 y observa —y escucha— cómo pasas de una imagen central a una sola fuente hacia la izquierda, y finalmente a un eco separado. Prueba lo sorprendente: sube el nivel del canal retardado y verás que hace falta ~+10 dB para recuperar el centro:
Este es el fundamento de las torres de retardo en un concierto: se les añade un retardo para que su sonido llegue después del escenario, de modo que —por precedencia— sigas localizando la música en el escenario aunque la torre cercana esté igual de fuerte.
17.2 Localización y precedencia: la primera onda manda
Lo que el cerebro hace con la diferencia de tiempo \(\Delta t\) entre dos llegadas depende de su magnitud, y cae en tres regímenes bien medidos:
| \(\Delta t\) | Percepción | Consecuencia práctica |
|---|---|---|
| < 1 ms | suma: una sola imagen, posición por tiempo/nivel | paneo estéreo |
| 1–40 ms | precedencia (Haas): una fuente, localizada por la 1.ª onda | torres de retardo; hacen falta +10 dB para recentrar |
| > 50 ms | umbral de eco: dos eventos separados | eco audible |
Dentro de una sola imagen, situamos la fuente combinando dos pistas entre los oídos —la teoría dúplex de Rayleigh—, cada una dominante en su rango:
| Pista | Rango dominante | Mecanismo |
|---|---|---|
| ITD (tiempo interaural) | < 1,5 kHz | diferencia de camino a cada oído |
| ILD (nivel interaural) | > 1,5 kHz | sombra acústica de la cabeza |
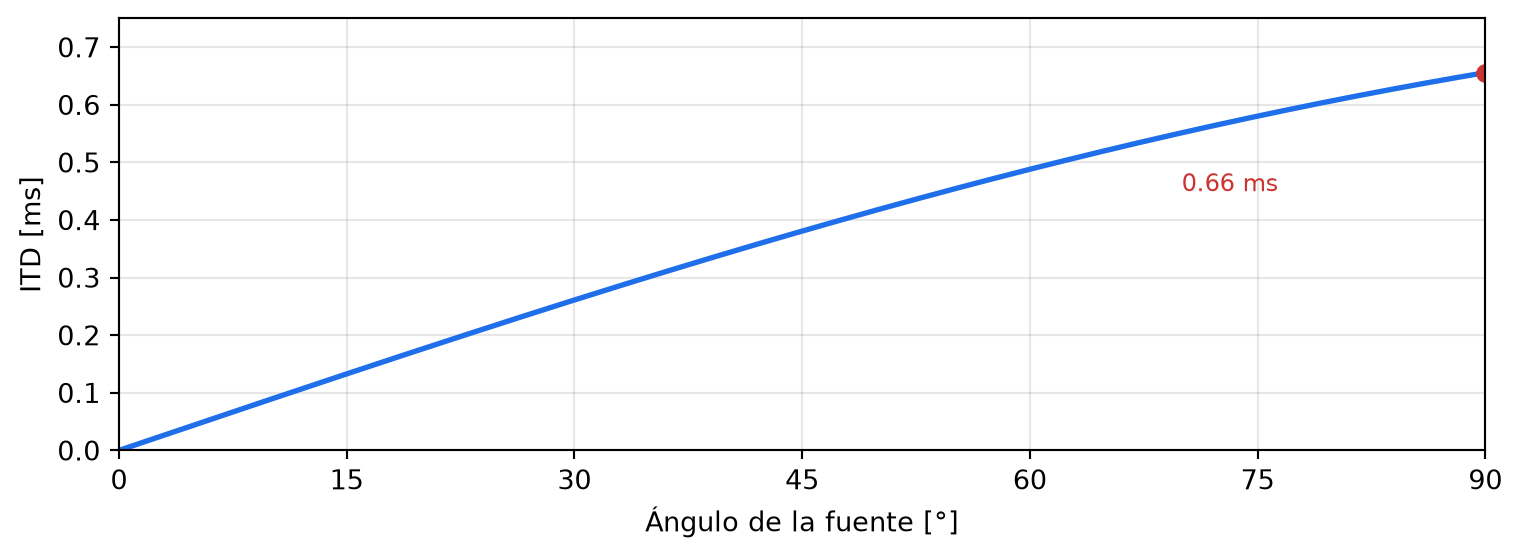
La ITD en función del ángulo la da el modelo de Woodworth, \(\text{ITD}(\theta) \approx \frac{a}{c}(\theta + \sin\theta)\) (con \(a\) el radio de la cabeza), y satura hacia los lados:
Importante¿Quieres ir más a fondo? — El efecto de precedencia
La fusión de la onda directa con sus reflexiones tempranas ocurre en ventanas temporales bien medidas [1], [2]:
- \(\Delta t \lesssim 1\) ms → localización por suma: las dos llegadas forman una sola imagen cuya posición depende de la diferencia de tiempo/nivel (base del paneo estéreo).
- \(1\ \text{ms} \lesssim \Delta t \lesssim 40\) ms → precedencia (Haas): se percibe una sola fuente, localizada por la primera llegada; la segunda aporta timbre y “cuerpo” pero no posición. Recuperar el centro exige subir la retardada unos +10 dB (la “ley de los 10 dB” de Haas).
- \(\Delta t \gtrsim 50\) ms (voz) → se supera el umbral de eco y se oyen dos eventos.
Importante¿Quieres ir más a fondo? — Localización: la teoría dúplex
Situamos una fuente combinando dos pistas entre oídos [2]:
ITD (diferencia de tiempo interaural): domina por debajo de ~1,5 kHz. Para una cabeza de radio \(a\), el modelo de Woodworth da \[ \text{ITD}(\theta) \approx \frac{a}{c}\,(\theta + \sin\theta), \]
donde:
- \(\text{ITD}(\theta)\) — diferencia de tiempo interaural [s]
- \(\theta\) — ángulo de la fuente respecto al frente [rad]
- \(a\) — radio de la cabeza [m]
- \(c\) — velocidad del sonido [m/s]
con máximos de ~0,6–0,7 ms hacia los lados.
ILD (diferencia de nivel interaural): domina por encima de ~1,5 kHz, donde la cabeza hace sombra acústica.
Esta división por frecuencia es la teoría dúplex de Rayleigh. Ambas pistas dejan ambigüedades (el cono de confusión: puntos con igual ITD/ILD), que resolvemos moviendo la cabeza y con el filtrado direccional del pabellón auricular (las HRTF), base del audio espacial y binaural.
17.3 Los oídos de Bell Labs
Casi toda la psicoacústica que usa este capítulo se midió por una razón muy poco musical: el teléfono. En los años veinte y treinta, Bell Labs necesitaba saber cuánto podía recortar una voz sin que el cliente lo notara, y para eso tuvo que medir el oído humano con rigor industrial: de ahí salieron las curvas de Fletcher y Munson (1933) — el mapa de cuánto nivel necesita cada frecuencia para sonar igual de fuerte — y la primera teoría del enmascaramiento. El mismo Harvey Fletcher, por cierto, hizo en 1933 la primera transmisión de sonido estereofónico de la historia (la orquesta de Filadelfia con Stokowski, por líneas telefónicas a Washington), y Helmut Haas midió la precedencia en su tesis doctoral de Gotinga (1949–51) pensando en la inteligibilidad de los altavoces públicos [1], [3]. La moraleja para el oficio: estas curvas no son teoría de salón — son ingeniería medida sobre miles de oídos, y siguen siendo el manual de instrucciones del único instrumento que de verdad importa en la sala.
17.4 Por qué el enmascaramiento y la sonoridad cambian el diseño
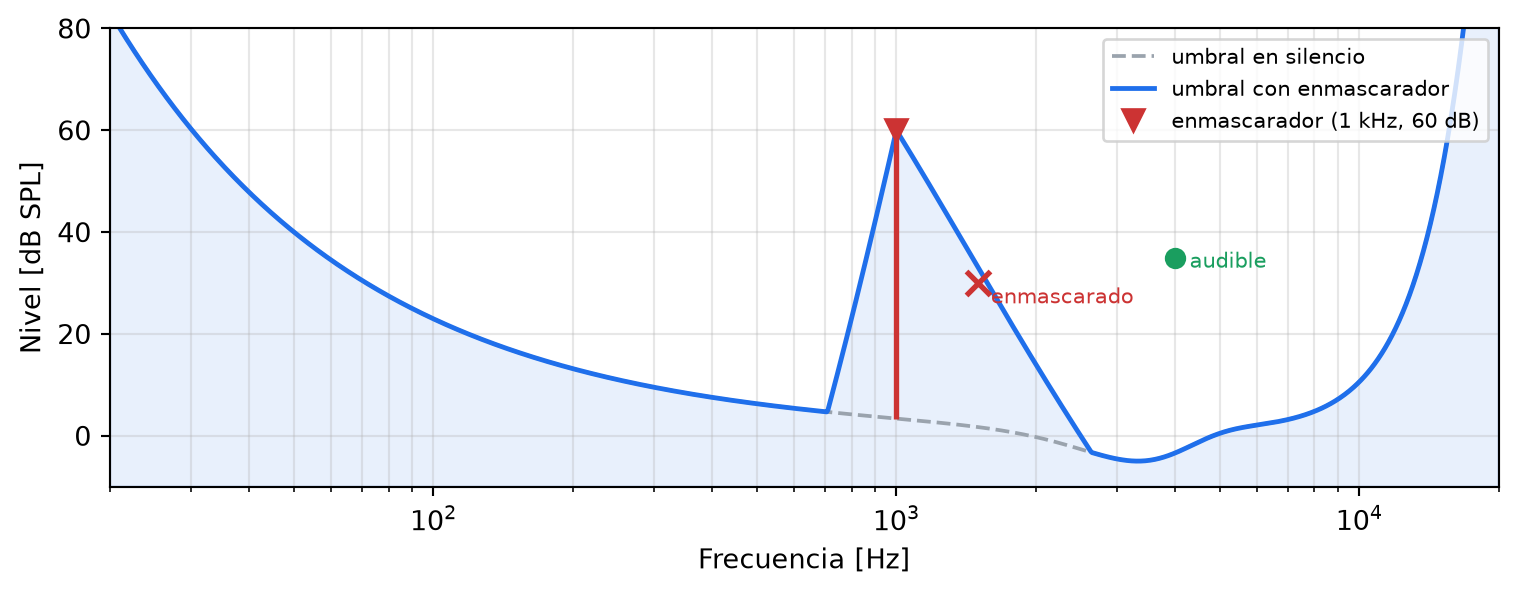
El enmascaramiento explica por qué un pequeño ruido o una resonancia puede ser inaudible junto a la música, y por qué un MP3 puede tirar el 90 % de los datos sin que lo notes: descarta lo que iba a quedar enmascarado [4]. Un tono fuerte eleva el umbral de audición en su banda y sus vecinas —más hacia las frecuencias altas que hacia las frecuencias bajas—; todo lo que quede bajo esa curva es inaudible y no hace falta reproducirlo ni codificarlo:
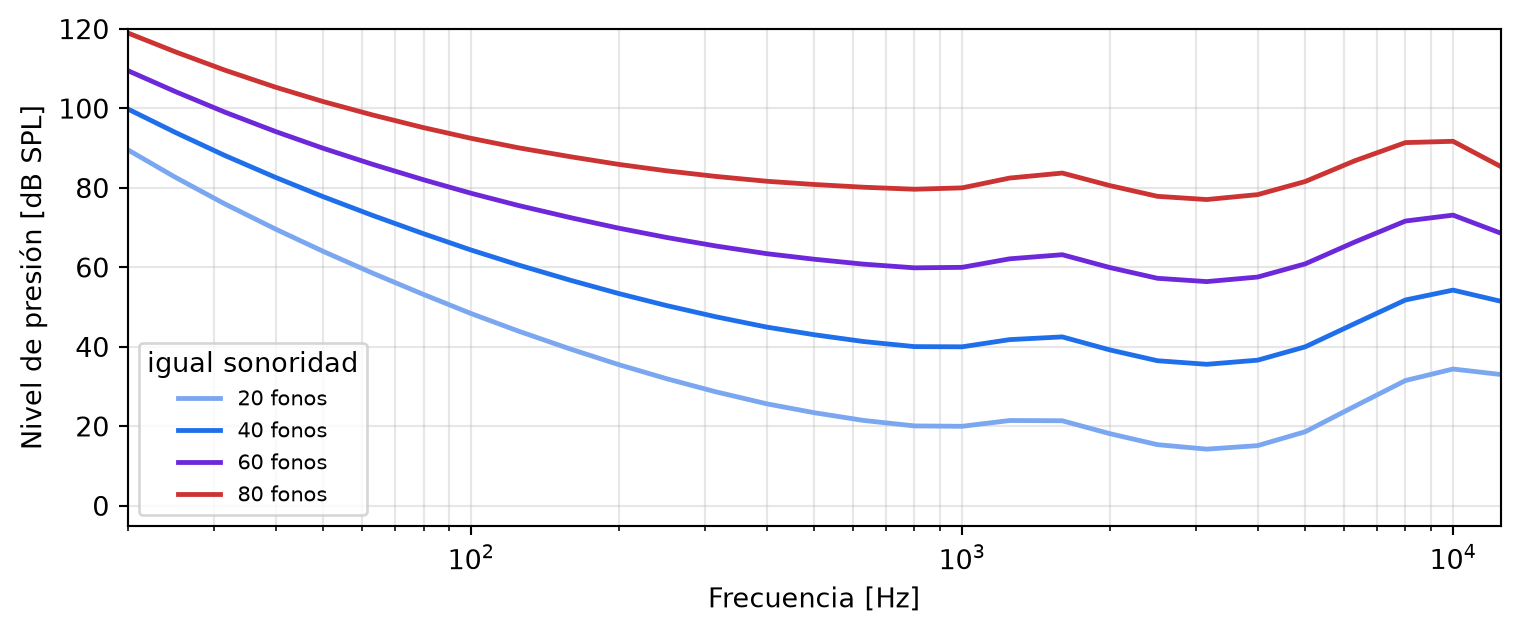
La sonoridad explica los mandos de “loudness” y por qué una mezcla suena distinta a bajo nivel: al bajar el nivel, las frecuencias bajas se “caen” antes que los medios [3]. Las curvas isofónicas (Fletcher-Munson, hoy ISO 226) unen los niveles de presión que producen igual sonoridad a cada frecuencia; la sonoridad se mide en fonos y en sonios, con \(S \approx 2^{(L_{\text{fon}}-40)/10}\) (+10 fonos ≈ el doble de sonoridad):
En ambos casos, el objetivo no es un número plano, sino una percepción correcta.
Importante¿Quieres ir más a fondo? — Enmascaramiento y bandas críticas
El oído analiza el sonido en bandas críticas (escala de Bark/ERB), como un banco de filtros solapados. Un tono enmascarador eleva el umbral de audición dentro de su banda y sus vecinas, formando una curva de enmascaramiento asimétrica (se enmascara más hacia frecuencias altas). El cociente entre la señal y ese umbral —la relación señal-máscara (SMR)— determina cuántos bits merece cada banda: es exactamente el criterio que optimizan los codificadores perceptuales [4], [5]. Hay además enmascaramiento temporal: pre-enmascaramiento (~20 ms antes) y post-enmascaramiento (~100–200 ms después) de un transitorio fuerte.
Importante¿Quieres ir más a fondo? — Sonoridad: de dB a fonos y sonios
Las curvas isofónicas de Fletcher-Munson (hoy normalizadas en ISO 226) unen los niveles de presión que producen igual sonoridad a cada frecuencia [3]. La sonoridad se mide en fonos (nivel en dB SPL de un tono de 1 kHz igualmente sonoro) y en sonios, donde \[ S \approx 2^{\,(L_{\text{fon}}-40)/10}, \]
donde:
- \(S\) — sonoridad [sonios]
- \(L_{\text{fon}}\) — nivel de sonoridad [fonos]
es decir, +10 fonos ≈ el doble de sonoridad. Como las curvas se aplanan a nivel alto, una mezcla ecualizada para sonar equilibrada a 85 dB pierde frecuencias bajas (y algo de frecuencias altas) al bajar el nivel — el porqué físico del mando “loudness”.
La lección de diseño. Medir es necesario, pero el criterio final es perceptual: se toleran (o se buscan) reflexiones tempranas que la precedencia funde en claridad; se ecualiza pensando en las curvas de sonoridad; se colocan retardos para que el cerebro localice donde queremos. La psicoacústica es el puente entre los capítulos de física y el sonido que de verdad se oye [6].
17.5 La rutina: usar el oído sin que te engañe
El oído es el juez final — y un juez sobornable. Esta rutina lo mantiene honesto durante un ajuste:
- Ecualiza al nivel del show. Las curvas de Fletcher-Munson no son simétricas con el volumen: una EQ hecha a nivel de conversación engaña — al subir al SPL real, las frecuencias bajas y las muy altas “aparecen” solas. Es la física del clásico “de noche sobran frecuencias bajas”. Ajusta el balance tonal al nivel al que se usará.
- Retardos con precedencia a favor. Al alinear una torre de retardo o un front-fill, no busques la simultaneidad exacta: añade 2–5 ms extra para que el refuerzo llegue justo después del sonido del escenario — la precedencia (widget de arriba) mantiene la imagen al frente y el refuerzo se vuelve invisible. La torre se oye; el escenario “canta”.
- A/B con bypass, siempre. La adaptación tarda segundos: cualquier cambio suena a mejora a los diez segundos de escucharlo. El bypass devuelve la referencia; sin él, solo estás acostumbrándote.
- Material conocido, de memoria. Se juzga contra una referencia interna: dos o tres temas que conozcas al detalle en sistemas buenos. La sala nueva se mide contra ellos, no contra el recuerdo de “cómo sonaba ayer”.
- Descansa el instrumento. Tras horas de SPL alto, el umbral se corre y el juicio de frecuencias altas se apaga (desplazamiento temporal del umbral): pausas de silencio, y las decisiones finas al principio de la sesión, no al final.
- Cuando el oído ya está cocido, manda la traza: coherencia alta + magnitud plana (capítulo 18) es el árbitro imparcial de las últimas horas. El oído firma; el analizador da fe — pero al revés también: si la traza dice “plano” y suena mal, revisa el paso 1.
Los errores clásicos: la EQ nocturna a bajo volumen que amanece retumbando; la torre alineada “exacta” que roba la imagen del escenario; y la mezcla de las 2 a. m. aprobada por un oído con 8 horas de fatiga.
17.6 Lecturas adicionales
17.7 Ejercicios
- En el widget, pon Δt = 8 ms y sube el nivel del canal retardado. ¿Cuántos dB necesitas para llevar la imagen al centro? Relaciónalo con la ley de los 10 dB de Haas.
- Una torre de retardo está a 34 m detrás del escenario. ¿Qué retardo hay que darle para que su sonido llegue justo después del directo del escenario y se mantenga la precedencia? (Usa \(c=343\) m/s.)
- Con el modelo de Woodworth y \(a=8{,}75\) cm, calcula la ITD máxima (\(\theta=90°\)) y compárala con el valor típico de 0,66 ms.
- Ecualizaste el sistema a 75 dB SPL y el show correrá a 102 dB. Usando las curvas isofónicas, ¿en qué dirección esperas que se desequilibre el balance tonal al subir el nivel, y en qué bandas? ¿Qué dice esto de la rutina “ecualiza al nivel del show”?
- Diseña un A/B honesto para juzgar un cambio de EQ: duración de cada tramo, cuál suena primero, cuántas repeticiones y por qué el bypass debe ser instantáneo (sin silencio entre A y B). Justifica cada elección con la adaptación y la memoria auditiva ecoica.